Ez az oldal a közösségért készül.
 Kövess minket máshol is:



 Ha hasznosnak találod, és szeretnéd, hogy folytatódjon, támogasd a munkát


A Linux kernel biztonsági karbantartása látványos fordulóponthoz érkezett. Míg a 6.x sorozat kiadásaihoz átlagosan valamivel több mint 500 CVE-hez kapcsolódó javítás tartozott, addig a 7.x sorozatban eddig soha nem látott mértékben emelkedett a javítások száma. A Linux 7.3 már 2872 ilyen javítással büszkélkedhet, ami több mint ötszöröse a korábbi sorozat átlagának.
A változás hátterében elsősorban a mesterséges intelligenciával támogatott kódelemzés (AI-assisted code analysis), valamint a nagy nyelvi modellek (Large Language Models, LLM) térnyerése áll. Ezek az eszközök olyan hibákat is képesek megtalálni a több évtizedes kódbázisban, amelyek korábban elkerülték a fejlesztők figyelmét. A jelenség azonban új problémát is teremtett: a kernel karbantartói egyre nehezebben tudják feldolgozni a beérkező hibajelentések és javítási javaslatok mennyiségét. Felmerül a kérdés: vajon egyre több biztonsági probléma kerül a felszínre, hatékonyabbá vált a hibák felderítése, vagy a kernel biztonsági karbantartásának módszertana változott meg? És ami talán még érdekesebb: ez az új szint tartósan velünk marad, tovább növekszik, vagy néhány kiadás után visszatérhet a korábbi, 500 körüli értékhez?
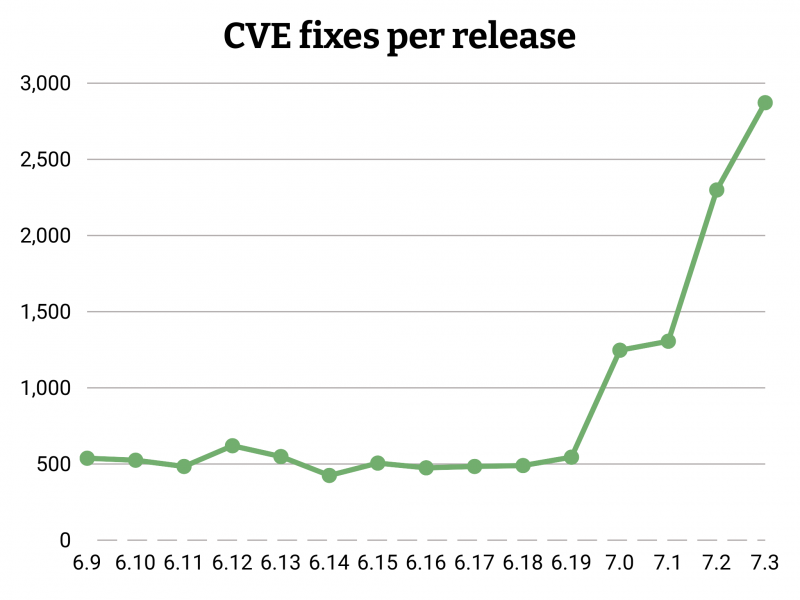
Mit mutat a grafikon?
A Greg Kroah-Hartman által bemutatott, CVE fixes per release című grafikon a Linux kernel egyes kiadásaihoz kapcsolódó CVE-javítások számát hasonlítja össze. A 6.9-es és a 6.19-es verzió közötti időszakban a számok viszonylag szűk tartományban mozogtak. A 7.0 megjelenésével azonban egyértelmű fordulat következett be, amelyet a következő kiadásokban további jelentős növekedés követett.
A rendelkezésre álló adatok a következőképpen alakulnak:
| Kernelverzió | CVE-javítások száma |
|---|---|
| 6.9 | 538 |
| 6.10 | 525 |
| 6.11 | 484 |
| 6.12 | 620 |
| 6.13 | 549 |
| 6.14 | 425 |
| 6.15 | 506 |
| 6.16 | 475 |
| 6.17 | 484 |
| 6.18 | 490 |
| 6.19 | 545 |
| 7.0 | 1247 |
| 7.1 | 1306 |
| 7.2 | 2299 |
| 7.3 | 2872 |
A 6.x sorozat vizsgált tizenegy kiadásában összesen 5641 javítás szerepel, ami kiadásonként átlagosan 513 javítást jelent. A 7.x sorozat első négy kiadásában már 7724 javítás gyűlt össze, vagyis az átlag 1931 kiadásonként.
Ez közel 3,8-szeres különbség a két sorozat átlaga között.
A változás különösen jól látható, ha a 7.x kiadások egymást követő értékeit vizsgáljuk:
- A Linux 7.0 kiadásában 1247 javítás szerepel.
- A Linux 7.1 esetében ez 1306-ra emelkedett.
- A Linux 7.2 már 2299 javítást tartalmazott.
- A Linux 7.3 pedig elérte a 2872-es értéket.
A 6.x sorozat utolsó szakasza meglehetősen stabil képet mutat. A javítások száma kisebb ingadozásokkal, de lényegében egy viszonylag szűk tartományban marad. A 7.0 megjelenésével azonban új szintre lép a görbe, majd a 7.2 és 7.3 kiadásoknál még nagyobb emelkedést láthatunk. A 7.3-as verzió a 7.2-höz képest további 573 javítást jelent, ami egyetlen kiadás alatt 24,9 százalékos növekedés. A korábbi, 6.x sorozat 513-as átlagához viszonyítva pedig már 5,6-szeres értékről beszélhetünk. A grafikon tehát nem egyszerűen egy lassú emelkedést mutat. A Linux kernel biztonsági karbantartásának üteme rövid idő alatt teljesen új szintre került.
A fordulópont: a mesterséges intelligencia megváltoztatta a hibakeresést
Mi okozza ezt a rendkívüli növekedést?
A legfontosabb tényező a mesterséges intelligencián alapuló kódelemző eszközök elterjedése. A Linux kernel több évtizedes fejlesztés eredménye, hatalmas és rendkívül összetett kódbázissal. Számos olyan alrendszert, illesztőprogramot és memóriakezelési mechanizmust tartalmaz, amelyet csak viszonylag kevesen ismernek mélyrehatóan.
A hagyományos kódellenőrzés, tesztelés és hibakeresés mellett az AI-alapú eszközök új lehetőségeket nyitottak. Képesek nagy mennyiségű forráskódot elemezni, összefüggéseket keresni a különböző alrendszerek között, és olyan potenciális hibákat azonosítani, amelyek emberi ellenőrzés során könnyen rejtve maradhatnak.
Különösen fontosak a memóriakezeléssel kapcsolatos problémák, például a use-after-free hibák, a határérték-túllépések, a versenyhelyzetek (race condition) és a hibás erőforrás-kezelés. Ezek a problémák sokszor csak speciális körülmények között jelentkeznek, és nehéz őket hagyományos tesztekkel előidézni.
Az AI-alapú elemzés azonban nemcsak újonnan keletkezett hibákat találhat meg, hanem évtizedek óta a kernelben lévő problémákat is felszínre hozhat.
Jonathan Corbet az LWN oldalán, a 2026. október 1-jén megjelent Coping with the onslaught of kernel security bugs című írásában számolt be Greg Kroah-Hartman Kernel Recipes 2026 konferencián tartott előadásáról. A bemutatott grafikon alapján a kernel korábbi, kiadásonkénti körülbelül 500 javításos üteme már a múlté. Kroah-Hartman szerint a projekt akkoriban még heti 50 javítást is rendkívül soknak tartott, mostanra viszont napi 33 CVE javítása vált jellemzővé.
A változás tehát nem pusztán a fejlesztők hatékonyabb munkáját jelenti: az automatizált hibakeresés alapvetően megváltoztatta azt is, hogy mennyi potenciális problémára derül fény.
Nem minden újonnan megtalált hiba jelent valódi veszélyt
Fontos különbséget tenni a biztonsági hibák száma és a ténylegesen kihasználható sérülékenységek száma között.
Az AI-alapú eszközök nem kizárólag súlyos, távolról kihasználható biztonsági réseket találnak. Sok esetben olyan hibákat jeleznek, amelyek:
-
csak nagyon speciális körülmények között válthatók ki;
-
ritkán használt vagy elavult hardverek illesztőprogramjaiban találhatók;
-
csak egy adott hibás állapotsorozat esetén okoznak problémát;
-
elméleti versenyhelyzeteket (race condition) vagy memóriakezelési problémákat jelentenek;
-
a gyakorlatban nehezen vagy egyáltalán nem használhatók ki támadásra.
Ettől még ezek a hibák nem feltétlenül jelentéktelenek. Egy memóriakezelési probléma például bizonyos körülmények között súlyosabb következményekhez is vezethet. Azonban a CVE-azonosító önmagában nem árulja el, hogy egy adott hiba mennyire veszélyes, milyen rendszereken érhető el, és milyen könnyen használható ki.
A Linux kernel saját CVE-eljárásának dokumentációja is hangsúlyozza ezt. A kernel CVE-kiosztásáért felelős csapat szándékosan óvatos: minden olyan hibajavításhoz rendelhet CVE-azonosítót, amelyet potenciális biztonsági problémának tekint. Ennek következtében a CVE-k száma magasabb lehet annál, mint amit a hagyományos értelemben vett, súlyos biztonsági rések száma indokolna.
Ezért a grafikon nem azt jelenti, hogy a Linux kernel négyszer-ötször veszélyesebbé vált. Sokkal inkább azt mutatja, hogy a fejlesztők és az automatizált eszközök sokkal több korábban rejtett hibát képesek megtalálni és kijavítani.
A fejlesztők is egyre nehezebben birkóznak meg a helyzettel
A mesterséges intelligencia ugyan rendkívül hatékonyan képes lehetséges hibákat találni, de az eredmények ellenőrzése és a javítások elfogadása továbbra is komoly emberi munkát igényel.
A Linux kernel fejlesztési modellje nagyrészt önkéntes és alrendszer-karbantartókra épülő együttműködésen alapul. Egy javítás nem kerülhet automatikusan a kernelbe csak azért, mert egy AI-eszköz hibát jelzett. A karbantartóknak meg kell érteniük a probléma természetét, ellenőrizniük kell a reprodukálhatóságát, meg kell vizsgálniuk a javítás helyességét, és biztosítaniuk kell, hogy a módosítás ne okozzon regressziót.
Jakub Kicinski, a Linux kernel hálózati alrendszerének karbantartója a 7.3 fejlesztési ciklusával kapcsolatban arról számolt be, hogy a vizsgált 648 javításból becslése szerint akár egyharmad és egy fél közötti arány is olyan, mesterséges intelligenciával támogatott módosítás lehetett, amelynek haszna vagy szükségessége kérdéses volt.
Ez komoly figyelmeztetés: az AI nemcsak a valódi hibák megtalálását gyorsítja fel, hanem a téves pozitív eredmények, a gyenge minőségű hibajelentések és a szükségtelen javítási javaslatok számát is növelheti.
A kernel karbantartóinak így kettős feladatuk van. Egyrészt nem hagyhatják figyelmen kívül a valódi biztonsági problémákat, másrészt meg kell védeniük a fejlesztési folyamatot a feldolgozhatatlan mennyiségű, alacsony minőségű beadványtól.
Greg Kroah-Hartman ennek megfelelően szigorúbb elvárásokat fogalmazott meg az AI által generált javításokkal kapcsolatban, többek között a staging alrendszerben. A cél nem a mesterséges intelligencia kizárása, hanem az, hogy a fejlesztők ellenőrizhető, reprodukálható és valóban hasznos eredményeket kapjanak.
Mi történik a régi, elhanyagolt illesztőprogramokkal?
A megnövekedett hibajavítási igény egy másik fontos kérdést is előtérbe helyez: meddig érdemes fenntartani a régi, alig használt kernelkódokat?
A Linux kernel számos olyan illesztőprogramot és alrendszert tartalmaz, amelyeket ma már kevés felhasználó használ. Ezek támogatása azonban továbbra is karbantartási kötelezettséget jelent.
Ha egy régi illesztőprogramban újabb és újabb hibákat találnak, a karbantartóknak mérlegelniük kell, hogy megéri-e továbbra is fenntartani az adott kódot. Egy elavult hardver támogatásának eltávolítása elsőre veszteségnek tűnhet, de bizonyos esetekben csökkentheti a kernel karbantartási terheit és támadási felületét.
A mesterséges intelligencia tehát közvetett módon a kernel tisztítását és egyszerűsítését is felgyorsíthatja.
Mi várható a következő kernelkiadásokban?
A legérdekesebb kérdés az, hogy a 2872-es érték csak egy átmeneti csúcs, vagy egy tartósan magasabb javítási ütem kezdete.
A jelenlegi adatok alapján három lehetséges forgatókönyv rajzolódik ki.
1. További növekedés a következő kiadásokban
Rövid távon ezt tartom a legvalószínűbbnek. A kernel nagy kódbázisában még számos olyan probléma lehet, amelyet az új elemzőeszközök csak most tárnak fel. Az AI-alapú hibakeresés ráadásul folyamatosan fejlődik, így a vizsgálatok hatékonysága tovább növekedhet.
A 3000-es határ átlépése ezért egyáltalán nem tűnik elképzelhetetlennek. Ha a jelenlegi ütem folytatódik, akár már a következő néhány kiadásban is új rekord születhet.
2. Magasabb szinten történő stabilizálódás
Hosszabb távon ezt tartom a legvalószínűbb forgatókönyvnek.
A jelenlegi növekedés egy része a korábban felhalmozódott, most feltárt hibák feldolgozásából eredhet. Ha ezek jelentős részét kijavítják, az egyszeri hibafeltárási hullám fokozatosan mérséklődhet.
Ettől azonban a korábbi, kiadásonkénti 500-as értékhez nem feltétlenül térünk vissza. Az automatizált elemzés tartósan a fejlesztési folyamat része maradhat, ezért a korábbinál több hiba kerülhet napvilágra minden egyes kiadási ciklusban.
Elképzelhető tehát egy új, magasabb egyensúlyi szint kialakulása, például 1000–1500 javítás körüli kiadásonkénti átlaggal. Ez természetesen csak szemléltető becslés, nem a kernel fejlesztőinek hivatalos előrejelzése.
3. Visszatérés az 500 körüli értékhez
Ez sem kizárható, de kevésbé tartom valószínűnek.
Ehhez a jelenleg feltárt hibák jelentős részének feldolgozására, a régi kódrészek megtisztítására, valamint a hibajelentések és a CVE-kiosztási gyakorlat esetleges változására lenne szükség.
Az 500 körüli szintre történő visszatérés ugyanakkor nem feltétlenül jelentene visszalépést. Elképzelhető, hogy a korábban felhalmozódott hibák kijavítása után már elsősorban az újonnan keletkező problémák jelennének meg a statisztikákban.
A következő néhány kiadás döntő lehet
A 7.4-es és az azt követő kernelkiadások adatai különösen fontosak lesznek. Ha a számok tovább emelkednek, az arra utalhat, hogy a hibafeltárási hullám még nem érte el a csúcspontját. Ha viszont csökkenés kezdődik, akkor elképzelhető, hogy a korábban felhalmozódott problémák jelentős részét már sikerült feldolgozni.
A következő időszakban ezért nemcsak a legmagasabb értékeket érdemes figyelni, hanem a több kiadáson keresztül számított átlagot és a javítások minőségét is.
Nem feltétlenül veszélyesebb lett a Linux, hanem alaposabban vizsgálják
A közel 3000 CVE-javítás első látásra riasztó lehet, de a számokat helyesen kell értelmezni. A Linux kernel nem feltétlenül lett sérülékenyebb: sokkal inkább arról van szó, hogy az új hibakeresési módszerek olyan problémákat is felszínre hoznak, amelyek korábban rejtve maradtak.
A változás ugyanakkor komoly kihívást jelent a fejlesztői közösség számára. A mesterséges intelligencia gyorsabban képes hibákat találni, mint ahogyan a karbantartók minden egyes jelentést ellenőrizni tudnak. A következő évek egyik fontos feladata ezért nemcsak a hibák megtalálása, hanem a beérkező eredmények szűrése, ellenőrzése és megfelelő kezelése lesz.
További források