Ez az oldal a közösségért készül.
 Kövess minket máshol is:


 Ha hasznosnak találod, és szeretnéd, hogy folytatódjon, támogasd a munkát

A Linux története nagy részében egy egyszerű feltételezésre épült. Van egy gép: processzorokkal, memóriával és eszközökkel, ezeket pedig a kernel kezeli. Vannak persze klaszterek is, de ezek többnyire az operációs rendszer fölötti rétegek gondjai voltak: ütemezők, orchestratorok, elosztott frameworkök.
Az AI-infrastruktúra ennél többet kíván. A mai tanító és következtető rendszerek tucatnyi CPU-t, NPU-t, GPU-t és memóriatömböt kötnek össze olyan szorosan, hogy már nem szerverek csoportjaként, hanem inkább egyetlen, nagyon nagy számítógépként viselkednek. Erre jönnek rá az AI agentek, amelyek nemcsak egy modellt futtatnak, hanem menet közben indítanak eszközöket, sandboxokat és hosszú életű munkameneteket.
Erre a gondolatra épült Xinwei Hu, az openEuler technikai bizottságának elnöke prágai előadása az Open Source Summit Europe 2026 konferencián.
Nézzük meg, hogyan újítja meg az openEuler a Linuxot az agent-alapú skálázás körül.
A probléma: már nem a szerver az alapegység
Az openEuler egyik keynote-diája ezt a váltást úgy írja le, mint kilépést a „dobozból”: az egyetlen gépről egy SuperPoD felé. A SuperPoD szorosan összekapcsolt rendszer, ahol sok node számítási kapacitása, memóriája és gyorsítói egyetlen erőforrás-készletként kapcsolódnak össze és úgy is kell működniük.
Ez olyan gondokat hoz elő, amelyekre a klasszikus operációs rendszert sosem tervezték. Az a memória, amire szükséged van, lehet, hogy egy másik node-on van. Egy gép hibája átterjedhet a többire. A hostok és gyorsítók közötti adatmozgatás szűk keresztmetszetté válhat. Valakinek pedig az egészet kezelnie kell.
Hu az openEuler céljait három nagy területre osztotta: használhatóság, megbízhatóság és teljesítmény.
SuperPoD OS: amikor egy rack úgy viselkedik, mint egy szerver
A használhatósági célok kifejezetten ambiciózusak. Az openEuler olyan runtime-okat és SDK-kat szeretne, amelyek SuperPoD hardveren azonnal, külön trükközés nélkül működnek. A rendszergazdai feladatokat pedig agent segítené, hogy egy SuperPoD-ot „úgy lehessen kezelni, mint egyetlen szervert”.
A megbízhatóság itt különösen kritikus. Hu szerint az openEuler 500 ms-on belüli késleltetéssel tudja értesíteni a többi node-ot egy node meghibásodásáról, és külön szálakat is figyelmeztet, ha a megosztott memóriában hiba lép fel. Cél az is, hogy a hibákat elszigeteljék, ne terjedjenek át más folyamatokra ugyanazon a gépen, és ne ugorjanak át más node-okra. Emellett van „fault storm suppression” is: gyors reagálás a távoli memóriahibákra, hogy a SEA hibák áradata ne fagyassza meg a rendszert.
Teljesítmény terén Hu előadásában két számot emelt ki. A UMDK, amelyet az openEuler egységes, heterogén interconnect infrastruktúraként ír le SuperPoD-okhoz, 20%-kal csökkenti az RPC késleltetését. Egy aszinkron pipeline és egységes memória-címtér pedig 20%-kal vágja vissza az RH2D (Remote Host-to-Device) késleltetést a KV cache műveleteknél.
Mindez a UnifiedBusra épül, amely egy hardveres interconnect protokoll, ugyanabba a családba tartozik, mint az NVLink, az RDMA és a CXL. Az openEuler architektúra-diáin két, erre épülő réteg látható. A UB OS Component az operációs rendszer meglévő komponensei mellé ad eszközkezelést, memória-poolokat, node-ok közötti kommunikációt és virtualizációt. A UB Service Core pedig magasabb szintű szolgáltatásokat nyújt (memória, kommunikáció, I/O, erőforrás-kezelő, virtualizáció, serverless, valamint fordító és runtime).
Számomra a leggyakorlatiasabb rész az, ahogyan az alkalmazások elérik mindezt. Az általános célú programok továbbra is a szokásos POSIX API-t használják, átlátszó hívásokkal, míg az AI-alkalmazások közvetlenül a UB Service Core API-ját érhetik el. Ha egy alkalmazásnak memória-poolra van szüksége, az UBS Engine megkeresi, mely szerverek tudnak memóriát nélkülözni, onnan exportálja, majd importálja a helyi gépre.
A UnifiedBus alapjairól korábban részletesebben is írtunk, ha érdekel a háttér.
Hol tart a mainline Linux
Az openEuler nincs egyedül. A mainline Linux évek óta dolgozik ugyanennek a problémának a memóriaoldalán, főleg a CXL segítségével. A CXL egy nyílt interconnect szabvány, amely lehetővé teszi, hogy a szerverek az alaplapra szerelt memórián túl további memóriát csatoljanak vagy osszanak meg.
A cél, hogy a távoli memória egyszerűen egy újabb NUMA (Non-Uniform Memory Access) node-ként jelenjen meg, így a legtöbb alkalmazást ne kelljen módosítani.
Nagyjából ugyanez a filozófia húzódik meg az openEuler átlátszó POSIX útvonala mögött. A különbség a hatókör. A mainline többnyire egyetlen hosthoz csatolt extra memóriával foglalkozik, míg a SuperPoD OS egyszerre próbálja összehangolni a memóriát, az eszközöket és a hibakezelést sok host között, egyelőre egy Huawei-eredetű interconnecten, nem pedig egy gyártófüggetlen szabványon.
Agentic Scaling: operációs rendszer a ciklusokban gondolkodó terhelésekhez
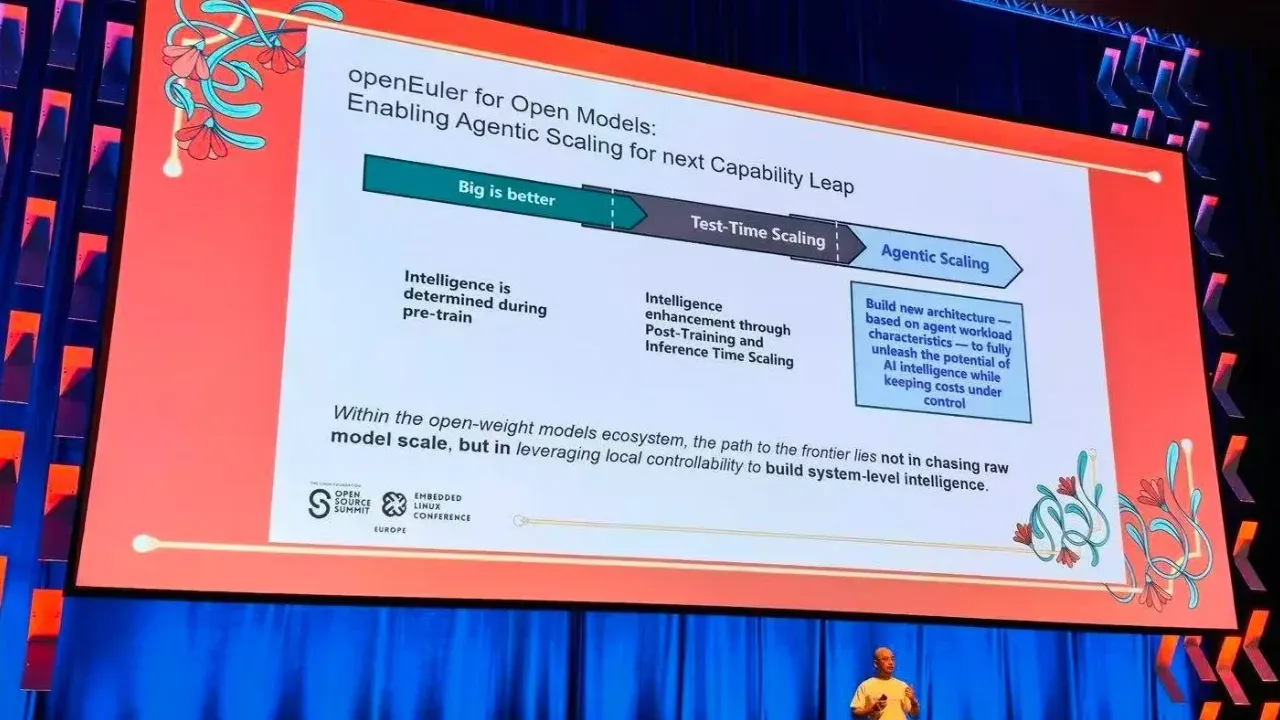
A keynote második fele a hardverről arra váltott, hogyan skálázódik maga az AI. Hu diáján három fázis szerepelt. Először jött a „big is better”, ahol az intelligencia a pre-training során rögzül. Utána a test-time scaling, ahol a modellek a post-traininggel és a futás közbeni többlet számítással lesznek okosabbak. A harmadik fázis az Agentic Scaling: új rendszerarchitektúra építése az ügynökök tényleges viselkedése köré, úgy, hogy közben a költségek kezelhetők maradjanak.
A koncepció kifejezetten az open-weight modellekre céloz (olyan modellekre, mint a DeepSeek, a Qwen vagy a Llama, amelyek súlyait le lehet tölteni és saját gépen futtatni). Az openEuler érvelése szerint ez az ökoszisztéma nem fog a csúcsra érni, ha csak a nyers modellt méretezi tovább. Inkább azt kell kihasználni, hogy a modellek helyben futnak, és így rendszerszinten lehet intelligenciát építeni.
Mit is jelent ez pontosan? Egy ügynök nem csak egyszer hív meg egy modellt. Eszközöket futtat, végrehajtja a generált kódot, hosszú munkamenetek alatt is megőrzi a memóriáját, és rengeteg rövid életű feladatot indít párhuzamosan. Ezek mind operációs rendszer szintű kérdések: izoláció, indulási idő, memóriakezelés és helyreállítás.
Az openEuler ügynökinfrastruktúráját bemutató diák ezek közül hármat céloznak meg.
Sandboxok. A kódot futtató ügynököknek izolált, eldobható környezetekre van szükségük. Az openEuler sandbox stackje együttműködik a Firecracker, StratoVirt, gVisor és Cloud Hypervisor megoldásokkal, és kompatibilis a Kubernetes és az E2B API-kkal. Előmelegített készletek és snapshot alapú helyreállítás segítségével a projekt szerint a cold start idő 20 ms-ig csökkenthető (70–95%-os csökkenés), több mint 2000 párhuzamos sandbox kezelhető, és a feladatok helyreállítási ideje több mint 50%-kal rövidül.
KV cache. A KV cache (a modell rövid távú „munkamemóriája” egy beszélgetéshez) gyorsan nő, ha hosszú a kontextus és sok a felhasználó. Az openEuler megközelítése négy szintre osztja: HBM az gyorsítón, helyi DRAM, közös DRAM pool a node-ok között UnifiedBuson keresztül, valamint SSD vagy objektumtároló a hideg adatoknak. Egy globális indexszel kombinálva, amely lehetővé teszi, hogy egy példány felhasználja egy másik által felépített cache-t, a projekt 30–70%-os csökkenést állít az első tokenig mért időben, és 1,5–3-szoros áteresztőképesség-növekedést.
Ügynökmemória. A hosszú távú ügynökmemóriához az openEuler az oGMemoryt mutatta be, amely az openGauss adatbázisra épül, vektoros, teljes szöveges és gráfos kereséssel. A dia szerint ez a token többletet a felére csökkenti, és 20%-kal javítja a feladatok sikeres befejezését.
Mit jelent ez a Linux számára?
Szerintem a legfontosabb tanulság az, hogy változik az „a gép” fogalma, amelyet egy operációs rendszer kezel, és az openEuler azon kevés disztribúció egyike, amely erre nyíltan épít.
Van azonban egy jogos fenntartás. A UnifiedBus, valamint a TaiShan és Atlas hardverplatformok szorosan kötődnek a Huawei technológiai ökoszisztémájához, és a SuperPoD stack nagy részét ezekre a platformokra optimalizálták.
Az igazi kérdés az, hogy ebből a munkából mennyi kerül feljebb a mainline Linuxba, és mennyire működik együtt a gyártófüggetlen szabványokkal, például a CXL-lel, ahelyett, hogy openEuler-specifikus funkció maradna. Mivel az openEuler már most is a Linux kernel egyik legnagyobb közreműködőjeként tartja számon magát, erre érdemes figyelni.
Akárhogy is, azok a kérdések, amelyeket Hu felvetett (hogyan kezeljen egy operációs rendszer olyan memóriát, amely fizikailag nem az övé, olyan hibákat, amelyeket nem ő okozott, és olyan munkaterheléseket, amelyek magukat szaporítják), hamarosan minden Linux disztribúció számára megkerülhetetlenné válnak.